Homem conecta 40 mini PCs por USB para rodar IA de 320 bilhões de parâmetros sem placa de vídeo

Um entusiasta de tecnologia encontrou uma maneira pouco convencional de executar um modelo avançado de inteligência artificial localmente. Em vez de investir em placas de vídeo de alto desempenho, ele reuniu 40 mini PCs equipados com processadores Intel N150, interligou os equipamentos por conexões USB e conseguiu gerar respostas utilizando o GLM-5.3-Flash, modelo que possui 320 bilhões de parâmetros.
O projeto foi apresentado pelo usuário Environmental_Hour66 no Reddit, na comunidade r/LocalLLM. Segundo o responsável, o conjunto alcança aproximadamente 14 tokens por segundo, com consumo máximo medido de 740 W e custo total declarado de cerca de US$ 5 mil.
Running GLM 5.3 Flash on a 40 mini PC cluster via USB 3 interconnects at 14 tps
byu/Environmental_Hour66 inLocalLLM
A montagem chama atenção por utilizar computadores compactos que o autor já possuía de outro projeto, transformando equipamentos modestos em uma infraestrutura distribuída para inteligência artificial.
Como funcionam os 40 mini PCs conectados por USB?
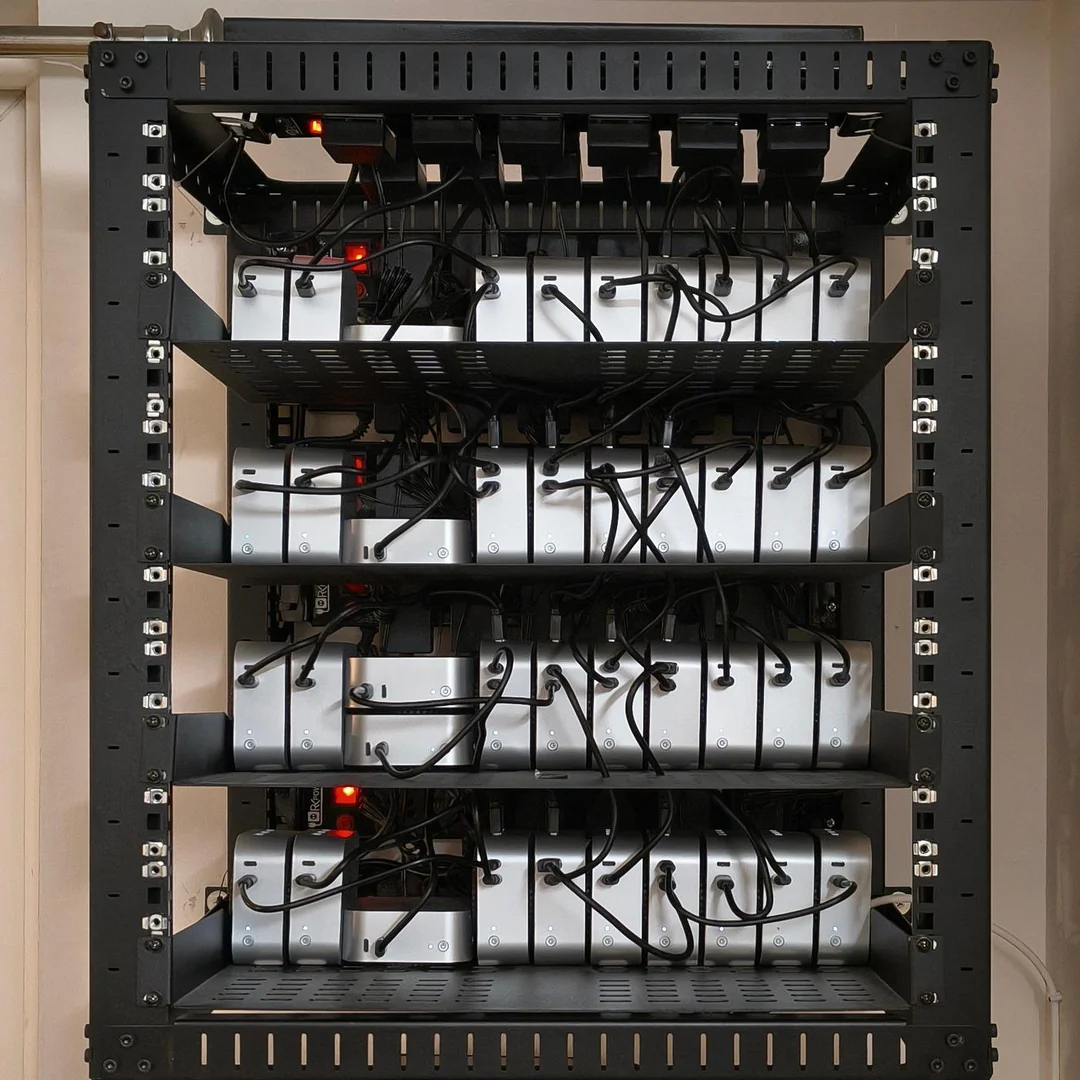
Cada computador utiliza um processador Intel N150 e 12 GB de memória DDR5-4800. Considerando as 40 unidades, o conjunto reúne 480 GB de memória RAM física, embora isso não signifique que toda essa capacidade esteja disponível diretamente para o modelo.
Os equipamentos também funcionam sem armazenamento local, utilizando uma arquitetura de nós sem disco.
O detalhe mais curioso está na comunicação entre as máquinas. Inicialmente, o desenvolvedor tentou interligá-las por conexões Ethernet de 1 Gb/s, mas o desempenho ficou limitado a aproximadamente sete tokens por segundo.
A solução foi utilizar conexões USB 3.2 de 10 Gb/s, explorando um recurso chamado USB Debug Capability (DbC), presente em determinados controladores xHCI.
Os computadores foram organizados em uma topologia de árvore, com quatro níveis distribuídos na proporção de 1, 3, 9 e 27 nós.
Essa abordagem permite que as máquinas compartilhem o trabalho necessário para executar o modelo, embora a comunicação entre os dispositivos continue representando um desafio para o desempenho.
A experiência é diferente de outro projeto apresentado no Hardware.com.br, no qual um entusiasta utilizou cinco NVIDIA Jetson Orin Nano para construir um cluster de agentes de IA. Naquela montagem, a proposta era distribuir tarefas entre modelos menores e especializados, em vez de executar um único modelo de grande porte.
Qual desempenho o conjunto consegue alcançar?
O modelo escolhido foi o GLM-5.3-Flash, desenvolvido pela Z.ai. Ele utiliza uma arquitetura Mixture of Experts (MoE), com 320 bilhões de parâmetros no total, mas aproximadamente 18 bilhões ativados por token.
Isso permite reduzir o trabalho computacional necessário para cada etapa de geração, embora o sistema ainda precise acomodar os pesos do modelo e administrar a comunicação entre os computadores.
Segundo os resultados divulgados pelo autor, a montagem alcançou:
- 14 tokens/s: geração com contexto de aproximadamente 1.000 tokens.
- 12 tokens/s: geração com contexto de 1 milhão de tokens.
- 40 tokens/s: desempenho agregado máximo utilizando processamento em lotes.
- 85 tokens/s: velocidade aproximada de processamento inicial da entrada (prefill).
Os números são preliminares e foram informados pelo próprio desenvolvedor. Não há, na publicação original, uma descrição completa do mecanismo de inferência utilizado nem uma validação independente dos testes.
O resultado também mostra como a comunicação entre dispositivos pode limitar um sistema distribuído. Mesmo reunindo 40 computadores, a velocidade de geração de uma resposta individual permanece relativamente modesta.
Mostramos recentemente um computador com quatro placas AMD Radeon e 128 GB de VRAM que alcançou 1.192 tokens por segundo em 16 fluxos simultâneos.
Projeto custou US$ 5 mil e consome até 740 W
De acordo com o responsável, o investimento total na montagem foi de aproximadamente US$ 5 mil. Ele também registrou um pico de consumo elétrico de 740 W, medido na tomada.
Isso não significa que o conjunto consuma continuamente essa potência. O valor representa a maior carga observada durante os testes.
O custo declarado também precisa ser contextualizado: o autor já possuía os mini PCs de um projeto anterior, circunstância que torna sua experiência diferente da de alguém que precisasse adquirir todos os equipamentos atualmente.
O responsável pelo projeto pretende continuar refinando a configuração, especialmente a etapa de processamento inicial das entradas. Entre as próximas possibilidades está a implementação de speculative decoding, técnica que pode acelerar a geração de respostas em determinadas condições.
O experimento demonstra que é possível explorar arquiteturas distribuídas para executar modelos grandes sem depender exclusivamente de GPUs dedicadas. Entretanto, também evidencia que reunir dezenas de computadores não garante desempenho proporcional à quantidade de hardware utilizada.

Editor-chefe no Hardware.com.br, aficionado por tecnologias que realmente funcionam. Segue lá no Insta: @plazawilliam Elogios, críticas e sugestões de pauta: william@hardware.com.br
Newsletter do Hardware
Tecnologia, games, IA e internet: nossa seleção de conteúdo direto no seu e-mail.
Inscrição feita!As próximas edições chegam no seu e-mail.