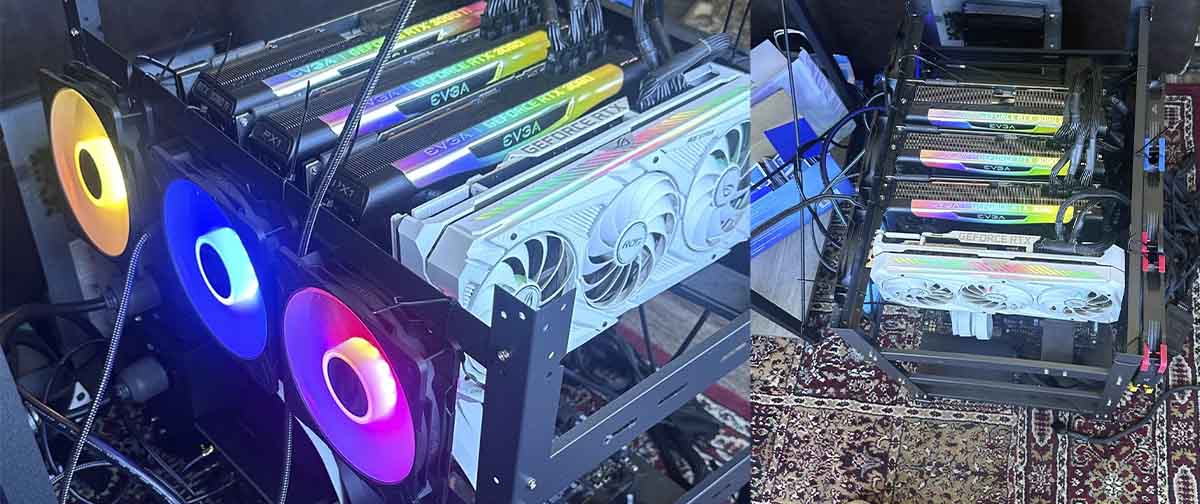
Enquanto NVIDIA e AMD disputam o mercado de aceleradores para inteligência artificial, alguns entusiastas continuam recorrendo a uma solução bem mais acessível: empilhar placas de vídeo GeForce usadas. Um usuário do Reddit levou essa estratégia ao extremo ao montar um servidor local equipado com quatro GPUs da família RTX 3090.
Publicado no subreddit r/LocalAIServers, o projeto de caramel_poison reúne duas EVGA GeForce RTX 3090 FTW3 Ultra, uma EVGA RTX 3090 Ti e uma ASUS ROG Strix RTX 3090. Como todas possuem 24 GB de memória, são 96 GB de VRAM instalados no sistema.
As fotos ajudam a explicar por que a RTX 3090 continua aparecendo tanto em projetos desse tipo: são quatro placas enormes instaladas em um gabinete aberto, com cabos, risers e ventoinhas ocupando praticamente todo o espaço disponível.
Para sustentar as quatro GPUs, o usuário partiu para uma plataforma que originalmente mirava estações de trabalho profissionais. O processador é um AMD Ryzen Threadripper PRO 5955WX, instalado em uma ASUS Pro WS WRX80E-SAGE SE WIFI II. A máquina também possui nada menos que 192 GB de DDR4-3200 ECC RDIMM, resultado da combinação de quatro módulos de 16 GB com outros quatro de 32 GB.
No armazenamento aparecem dois Samsung 990 Pro de 4 TB, totalizando 8 TB de SSD NVMe. O próprio autor explicou nos comentários que a máquina está sendo preparada como um servidor de IA para trading quantitativo autônomo, o que ajuda a justificar tanto a capacidade de armazenamento quanto a quantidade de memória.
Duas fontes de 1600 W entram em cena
Alimentar quatro RTX 3090 também exige uma infraestrutura elétrica fora do padrão de um desktop convencional.
O sistema utiliza uma EVGA SuperNOVA 1600 T2 e uma SuperNOVA 1600 G+, ambas de 1600 W. Isso não significa que o computador esteja consumindo 3.200 W continuamente, mas oferece margem para lidar com GPUs que individualmente podem trabalhar com centenas de watts. Nos comentários, outro usuário sugeriu inclusive limitar as RTX 3090 a 250 W para reduzir o consumo.
Há ainda um detalhe importante: os 96 GB de VRAM não funcionam automaticamente como um único bloco de memória, como aconteceria com uma GPU de 96 GB. Em aplicações de IA compatíveis, porém, modelos podem ser distribuídos entre várias GPUs, tornando configurações com múltiplas RTX 3090 particularmente interessantes para executar modelos grandes localmente.
Você também deve ler!
Estudante monta homelab com 24 TB, Core i9 e IA local para levar à faculdade
Homem monta servidor com 10 placas de vídeo para rodar IA local depender da nuvem