
Homem reaproveita peças antigas e monta servidor de IA com 48 GB de VRAM usando duas NVIDIA Tesla P40

Um entusiasta de hardware do Canadá encontrou uma maneira de montar seu próprio servidor de inteligência artificial sem investir em placas de vídeo de última geração. O projeto reúne um processador Intel Xeon antigo, uma placa-mãe de servidor da ASUS e duas GPUs NVIDIA Tesla P40, cada uma equipada com 24 GB de memória.
O resultado é uma máquina com 48 GB de VRAM instalada, capaz de executar modelos de linguagem localmente, incluindo uma configuração utilizada pelo proprietário para programação assistida por IA.
O projeto foi compartilhado pelo usuário Pyre-it no subreddit r/LocalAIServers, acompanhado de fotografias que mostram uma montagem bastante diferente dos computadores convencionais. Os componentes estão distribuídos sobre uma base de madeira, com cabos expostos, refrigeração adaptada e até um controlador de ventoinhas desenvolvido pelo próprio autor.
De placas de mineração a um servidor de inteligência artificial
A ideia inicial era aproveitar algumas Radeon RX 5700 que haviam sobrado de uma antiga operação de mineração de criptomoedas. O proprietário instalou as placas em uma ASUS B250, mas ficou insatisfeito com os resultados.
Decidiu então vender quatro dessas GPUs e procurar alternativas entre os componentes que já possuía.
A configuração escolhida utiliza uma placa-mãe ASUS Z10PA-U8, processador Intel Xeon E5-2630 v3 e 16 GB de memória DDR4 ECC Registered. O destaque fica para as duas NVIDIA Tesla P40, aceleradoras baseadas na arquitetura Pascal, originalmente desenvolvidas para aplicações em servidores e centros de dados.
Cada Tesla P40 oferece 24 GB de memória GDDR5. Embora sejam placas antigas, a capacidade de memória continua sendo um atrativo para quem pretende executar modelos de IA que não caberiam integralmente na VRAM de muitas GPUs convencionais.
Isso não significa, entretanto, que as duas placas funcionem como uma única GPU de 48 GB. O software precisa distribuir o processamento e os dados entre os dispositivos.
Refrigeração feita com impressão 3D e Arduino Nano
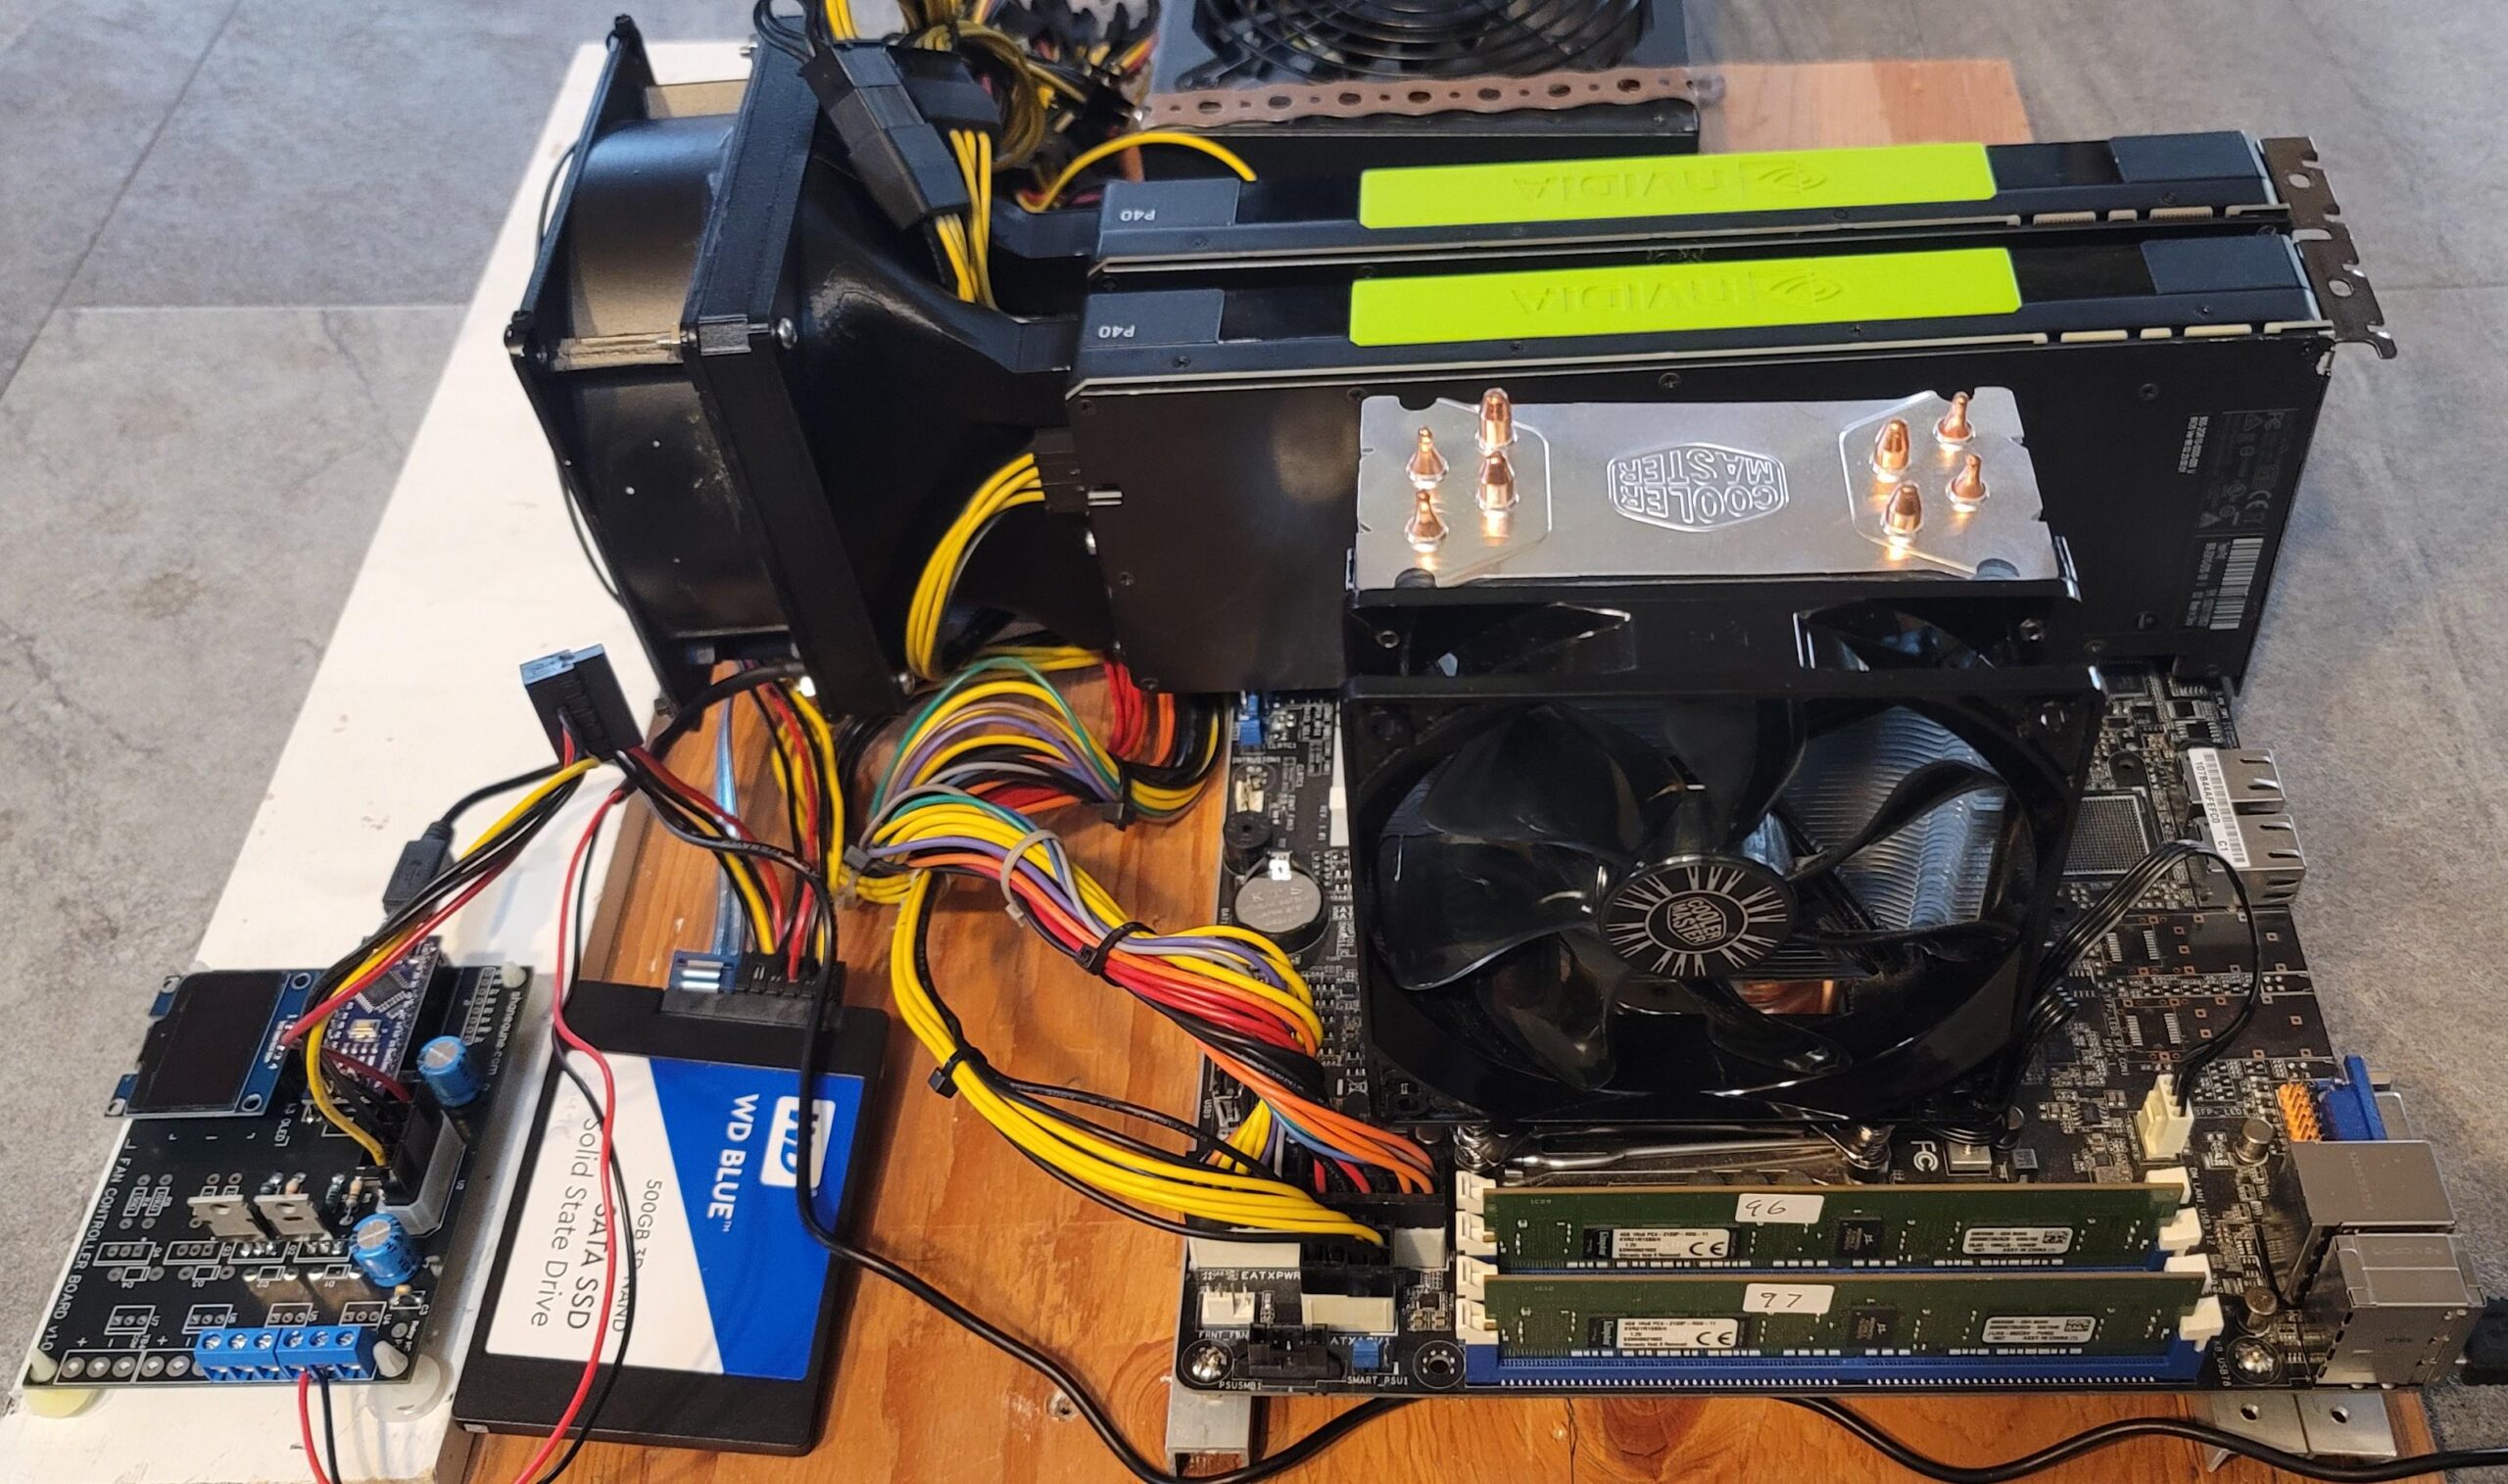
Uma das partes mais curiosas do projeto está no sistema de refrigeração. Como as Tesla P40 foram projetadas para servidores com fluxo de ar dedicado, o proprietário precisou improvisar uma solução para manter as temperaturas sob controle.
Ele imprimiu em 3D um duto de ventilação e instalou uma ventoinha ADDA de 120 mm e 0,5 A. O controle ficou a cargo de um Arduino Nano, programado para consultar o utilitário nvidia-smi a cada dez segundos.
Com essas informações, o microcontrolador ajusta a velocidade da ventoinha e apresenta a temperatura e o consumo das GPUs em uma pequena tela OLED.
O sistema também possui uma proteção: se o controlador deixar de receber informações, a ventoinha passa automaticamente para 100% da velocidade. O projeto admite até quatro canais de ventilação, embora apenas um esteja sendo utilizado atualmente.
Servidor executa modelo de IA com janela de contexto de 128 mil tokens
Na parte de software, o servidor utiliza Proxmox VE para virtualização, com uma máquina virtual Ubuntu 24.04 dedicada à inteligência artificial.
As duas Tesla P40 são disponibilizadas diretamente para essa máquina virtual, que utiliza Ollama para executar os modelos e Open WebUI como interface acessível pelo navegador.
Segundo o proprietário, sua principal ferramenta de programação é um modelo Qwen de 27 bilhões de parâmetros, configurado com uma janela de contexto de 128 mil tokens e distribuído entre as duas GPUs.
O OpenCode se conecta remotamente ao Ollama, permitindo utilizar o servidor para auxiliar no desenvolvimento de software.
A configuração também conta com desligamento automático durante períodos de inatividade e um mecanismo independente de proteção contra superaquecimento das GPUs.
O desempenho não impressiona, mas atende às necessidades do proprietário
O próprio criador admite que a máquina está longe de ser rápida. Questionado sobre o desempenho, ele respondeu que não, mas que o servidor consegue realizar o trabalho necessário.
O autor também reconhece que nunca utilizou os modelos comerciais de programação mais populares, executados na nuvem, e por isso não dispõe de uma referência direta para comparar os resultados.
A publicação não apresenta medições de velocidade de geração de tokens, consumo elétrico total ou custo final da montagem. Também não informa a quantização utilizada pelo modelo.
Mesmo com essas limitações, o proprietário afirma estar satisfeito com a experiência e espera adicionar novas GPUs quando os preços estiverem mais acessíveis.
O projeto mostra uma alternativa interessante para entusiastas que desejam experimentar IA local aproveitando equipamentos antigos, embora não seja possível determinar sua relação entre custo e desempenho sem medições adicionais.

Editor-chefe no Hardware.com.br, aficionado por tecnologias que realmente funcionam. Segue lá no Insta: @plazawilliam Elogios, críticas e sugestões de pauta: william@hardware.com.br
Newsletter do Hardware
Tecnologia, games, IA e internet: nossa seleção de conteúdo direto no seu e-mail.
Inscrição feita!As próximas edições chegam no seu e-mail.