“Finalmente consegui”: Homem monta servidor de IA com 8 placas de vídeo, 256 GB de RAM e processador AMD EPYC
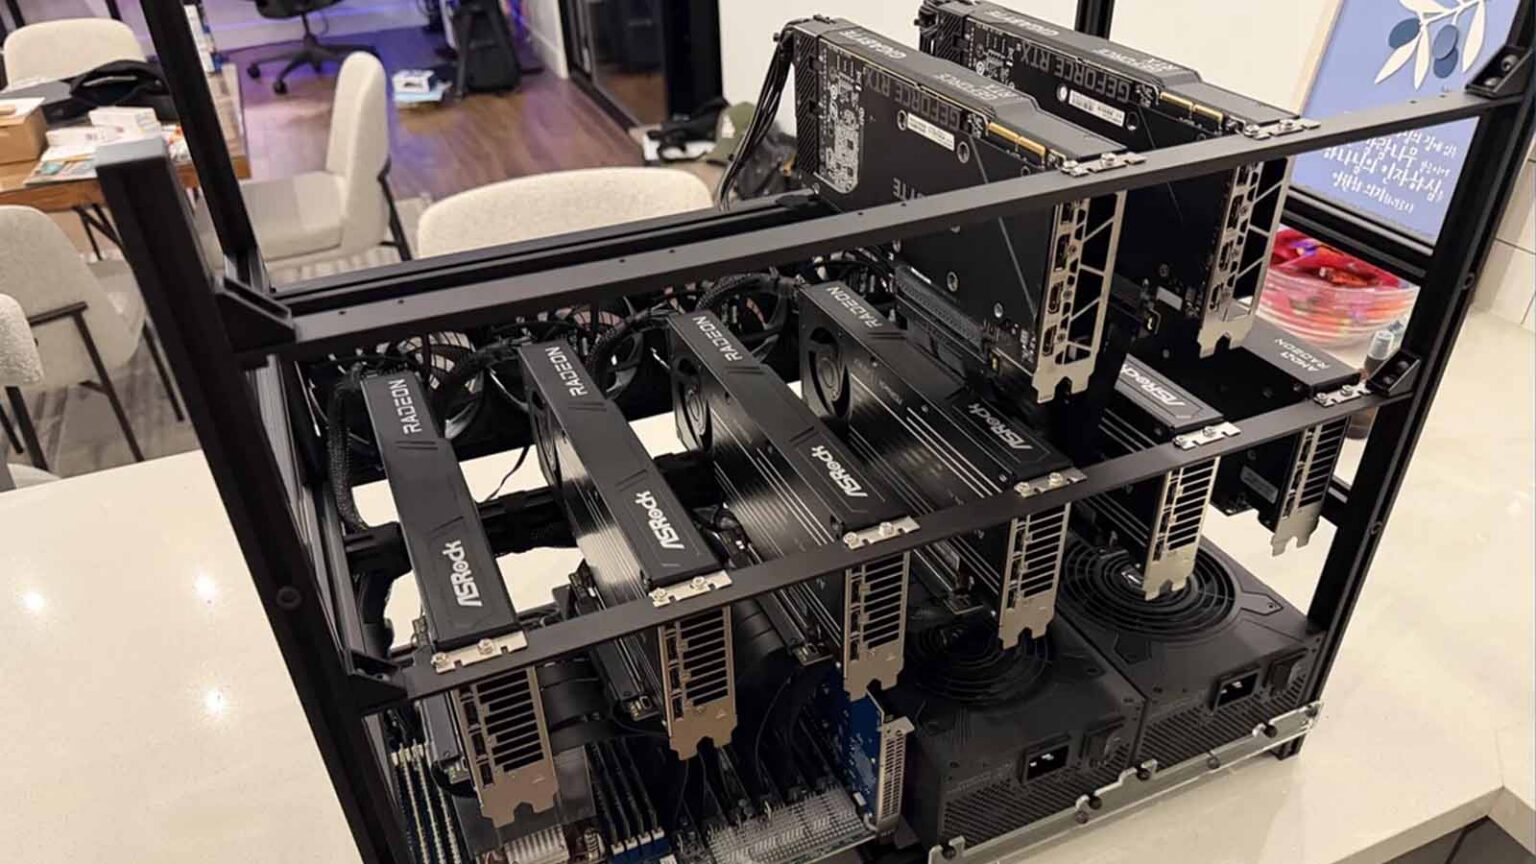
Um usuário do Reddit identificado como Eroji compartilhou uma configuração de servidor dedicada à execução local de inteligência artificial. O equipamento reúne oito placas de vídeo, 256 GB de memória RAM DDR4 ECC e um processador AMD EPYC. A montagem utiliza uma estrutura aberta, semelhante às empregadas em rigs de mineração de criptomoedas.
O projeto foi apresentado na comunidade r/LocalLLM, onde o responsável descreveu o servidor como uma solução relativamente econômica para suas necessidades. A escolha das palavras chamou a atenção de outros participantes, considerando a quantidade de GPUs instaladas.
Eroji explicou que boa parte dos componentes já fazia parte de seu laboratório doméstico (homelab) e foi acumulada ao longo dos anos. Com o crescimento do interesse por inteligência artificial, decidiu reaproveitar o hardware para montar um servidor capaz de executar diferentes modelos e ferramentas localmente.
Servidor combina seis GPUs AMD e duas RTX 3090
A configuração utiliza uma placa-mãe ASRock ROMED8-2T/BCM, equipada com um AMD EPYC 7313, processador de 16 núcleos e 32 threads. O conjunto inclui 256 GB de memória DDR4-2666 ECC, um SSD corporativo Samsung PM1725b de 3,2 TB e uma placa de expansão PCIe baseada no switch PLX88096.
O destaque está nas oito GPUs, divididas entre dois fabricantes. São seis Radeon R9700 da AMD e duas GeForce RTX 3090 da NVIDIA.
Quatro placas AMD são destinadas à execução do modelo Qwen3.8 Flash Next, enquanto as outras duas ficam responsáveis pelo Qwen3.8-27B Uncensored.
As RTX 3090 atendem a outras tarefas. Uma delas é utilizada com o ComfyUI, ferramenta voltada à geração de imagens por inteligência artificial. A segunda executa recursos como VoxCPM2 para síntese de voz, Whisper para transcrição de áudio, além de processos de embedding e reranking, empregados em sistemas de recuperação de informações.
Essa divisão permite distribuir diferentes cargas de trabalho entre as GPUs, sem depender de uma única placa para todas as operações.
Sistema alcança até 800 tokens por segundo, segundo o responsável
Nos comentários da publicação, Eroji apresentou alguns resultados obtidos com o Qwen3.8 Flash Next.
Utilizando uma implementação do vLLM com descarregamento de especialistas para a memória RAM, o servidor teria alcançado aproximadamente 200 tokens por segundo em uma única sequência de geração. Com oito sequências simultâneas, o rendimento agregado informado ficou entre 700 e 800 tokens por segundo.
Os números foram relatados pelo próprio usuário e não passaram por verificação independente. Também não foram apresentados todos os parâmetros necessários para reproduzir os testes.
Outro dado compartilhado foi o consumo elétrico em repouso, estimado em aproximadamente 178 W. Questionado sobre possíveis limitações da interface PCIe 4.0 na comunicação entre as GPUs, Eroji afirmou não ter encontrado gargalos relevantes em sua utilização.
O servidor também utiliza múltiplas fontes de alimentação, sincronizadas por meio de um adaptador ADD2PSU. A montagem permanece em uma sala dedicada, com as ventoinhas operando em velocidades elevadas para controlar as temperaturas.
Apesar da quantidade de hardware disponível, o responsável ainda pretende melhorar a configuração. Ele mencionou o interesse em placas NVIDIA mais potentes, especialmente para trabalhar com o ComfyUI, e aguarda novas variantes do Qwen4 para atualizar os modelos utilizados.
Por enquanto, o conjunto já atende praticamente todas as suas necessidades de inteligência artificial local, segundo o relato publicado no Reddit.

Editor-chefe no Hardware.com.br, aficionado por tecnologias que realmente funcionam. Segue lá no Insta: @plazawilliam Elogios, críticas e sugestões de pauta: william@hardware.com.br
Newsletter do Hardware
Tecnologia, games, IA e internet: nossa seleção de conteúdo direto no seu e-mail.
Inscrição feita!As próximas edições chegam no seu e-mail.