New York Times processa o navegador Brave por roubo de conteúdo para alimentar IAs
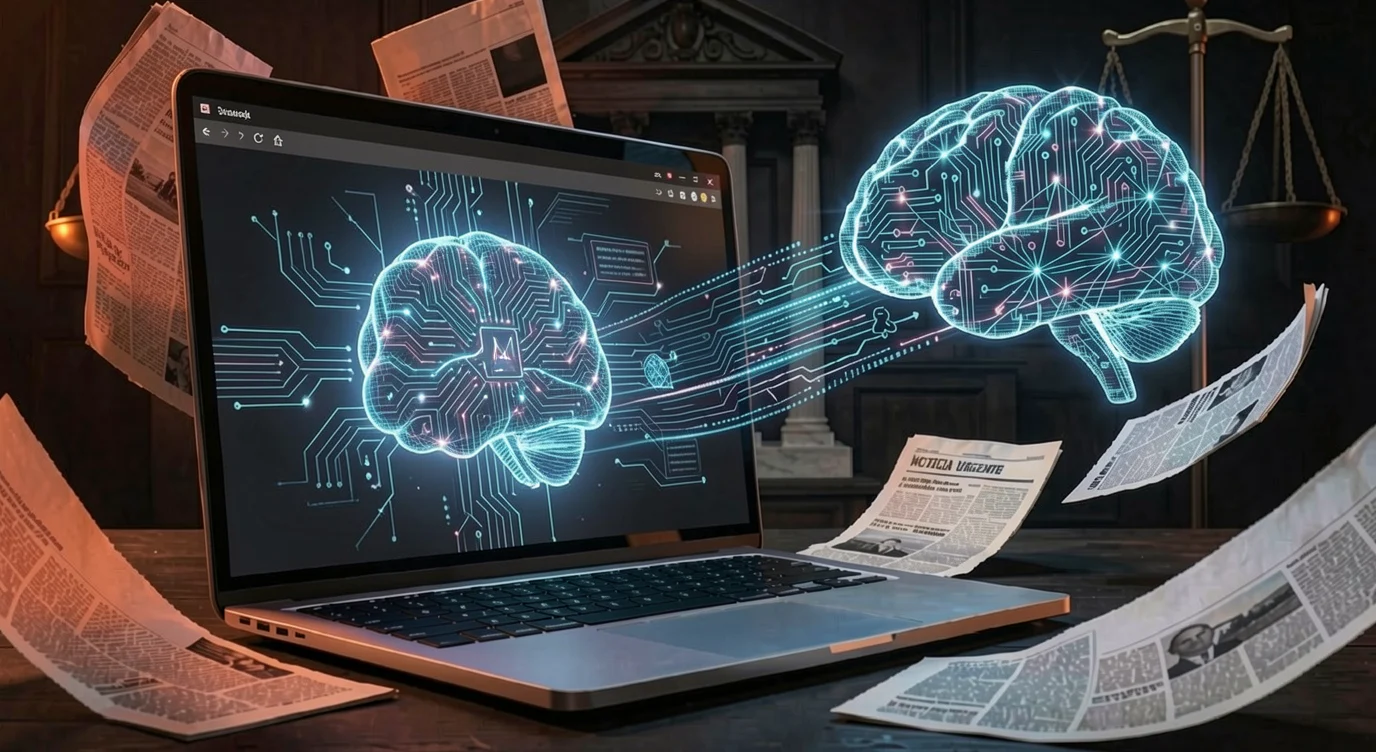
O navegador Brave está no centro de um processo judicial que mostra a tensão entre o modelo de negócios da inteligência artificial e os direitos autorais da imprensa. O New York Times entrou com uma ação contra a Brave Software, enquanto o New York Daily News, o Chicago Tribune e o Orlando Sentinel protocolaram uma queixa conjunta acusando a empresa de dois movimentos distintos, mas igualmente problemáticos: o roubo de conteúdo protegido para alimentar modelos de IA e oferecer aos usuários uma ferramenta nativa de desbloqueio de paywalls sem qualquer autorização dos veículos afetados.
Conteúdo de terceiros vendido como serviço
De acordo com o documento protocolado, a Brave Software construiu e monetizou um índice próprio de páginas roubadas da web, o Brave Index, e passou a oferecer acesso pago a esse índice para empresas de IA. Essas empresas, por sua vez, usam o material para treinar seus modelos, para responder a consultas de usuários em tempo real, ou para ambas as finalidades. A queixa cita nominalmente Anthropic, Perplexity, Mistral, xAI e Cohere como empresas que teriam recebido acesso a esse conteúdo classificado pelos autores da ação como “conteúdo protegido por direitos autorais roubado”.
A segunda acusação é mais visível para qualquer usuário do browser: o recurso de Paywall blocker, que o próprio Brave promove como compatível com “centenas das principais editoras”. A queixa é direta ao apontar que a empresa “jamais pediu permissão às editoras para acessar seus sites, muito menos para copiar o material e fornecê-lo a usuários ou a outras empresas de IA”.
Acusações e resposta
Graham James, porta-voz do New York Times, afirmou ao The Verge que o veículo “acredita no uso ético e responsável da IA“, mas que a Brave “desrespeitou a legislação de direitos autorais estabelecida e ignorou pedidos repetidos do Times para cessar a conduta infratora“. A ação foi descrita como uma resposta necessária para “responsabilizar a Brave por roubar nosso conteúdo para alimentar seus próprios produtos e fornecê-lo a algumas das empresas de IA generativa mais proeminentes e bem financiadas do mundo”.
Steven Lieberman, o advogado que protocolou a ação em nome dos outros três veículos, foi mais enfático ao caracterizar o papel da Brave Software na cadeia: “Os gigantes da IA estão desesperados para não serem pegos em flagrante roubando notícias de editoras, então a Brave Software está vendendo a eles uma porta dos fundos para o jornalismo que eles sabem que não têm direito de acessar. Comprar mercadoria roubada de segunda mão não a torna legítima.”
Do lado das acusadas, apenas a Perplexity se manifestou até o fechamento da matéria. Jesse Dwyer, diretor de comunicações da empresa, optou pelo ataque: “O New York Times está pagando demais seus advogados e de menos seus jornalistas. (Que poderiam ter facilmente identificado a desinformação nesta ação.)”.
O que este processo coloca sob holofotes é a arquitetura de abastecimento de dados que sustenta parte do mercado de IA generativa. Se a acusação se sustentar, o modelo descrito, em que um intermediário rouba conteúdo, indexa e revende acesso a empresas que já enfrentam suas próprias batalhas de direitos autorais, representa um elo da cadeia que as grandes companhias de IA preferem não expor.
Usuários divididos no assunto
The New York Times sues Brave web browser for AI scraping and bypassing paywalls | Brave has allegedly provided ‘stolen copyrighted content’ to many AI companies
byu/Hrmbee intechnology
No Reddit, a repercussão do processo dividiu opiniões entre críticas à Brave e desconfiança em relação às próprias editoras. No subreddit r/technology, alguns usuários apontaram a ironia de uma reportagem sobre desbloqueio de paywalls estar, ela mesma, protegida por um paywall. “Um artigo sobre burlar paywalls atrás de um paywall…”, brincou um dos comentários mais votados.
Outros demonstraram preocupação com a forma como empresas de IA obtêm conteúdo jornalístico. Um usuário argumentou que, embora indexar artigos em mecanismos de busca seja aceitável, copiar reportagens completas para alimentar modelos de inteligência artificial sem licença é outra questão. Também houve quem enxergasse a Brave como uma intermediária que permite às grandes empresas de IA acessar conteúdos que elas preferem não coletar diretamente.
Por outro lado, parte da comunidade saiu em defesa do navegador e criticou o modelo de assinaturas das publicações. Alguns usuários consideraram os paywalls uma barreira desnecessária ao acesso à informação, enquanto outros questionaram por que os veículos não processam também gigantes como Meta e Amazon. Um comentário resumiu essa posição: “A Brave está prestando um serviço e espero que vença”.
A discussão também revelou uma divisão sobre os direitos autorais na era da IA. Enquanto alguns defenderam que as empresas precisam ser responsabilizadas pelo uso de conteúdo protegido, outros demonstraram pouca simpatia pelo New York Times e pelas demais publicações, reforçando que não pretendem pagar por suas assinaturas.
Você também pode se interessar:
Fonte: The Verge
Newsletter do Hardware
Tecnologia, games, IA e internet: nossa seleção de conteúdo direto no seu e-mail.
Inscrição feita!As próximas edições chegam no seu e-mail.