Treinar um modelo de inteligência artificial para interagir com um jogo clássico como Pokémon Red não é novidade. O que chama atenção no projeto do desenvolvedor stmonty é a escala: um modelo com apenas 12,5 milhões de parâmetros, treinado em uma única RTX 3080 Ti de consumidor, sem acesso a clusters em nuvem, sem orçamento corporativo.
O resultado publicado em 20 de setembro não é o jogo sendo completado, mas é algo conceitualmente mais interessante: um modelo pequeno, construído do zero, que aprendeu o que cada botão faz simplesmente observando as consequências na tela.
O que é um world model e por que isso importa aqui
O projeto parte de uma arquitetura conhecida como world model, construída sobre a pesquisa LeWorldModel, co-autorada pelo cientista Yann LeCun, que deixou a Meta no ano passado para fundar o AMI Labs com foco exatamente nesse tipo de abordagem. A ideia central é que o modelo não recebe regras do jogo, não é informado sobre condições de vitória e não processa a tela inteira a cada frame.

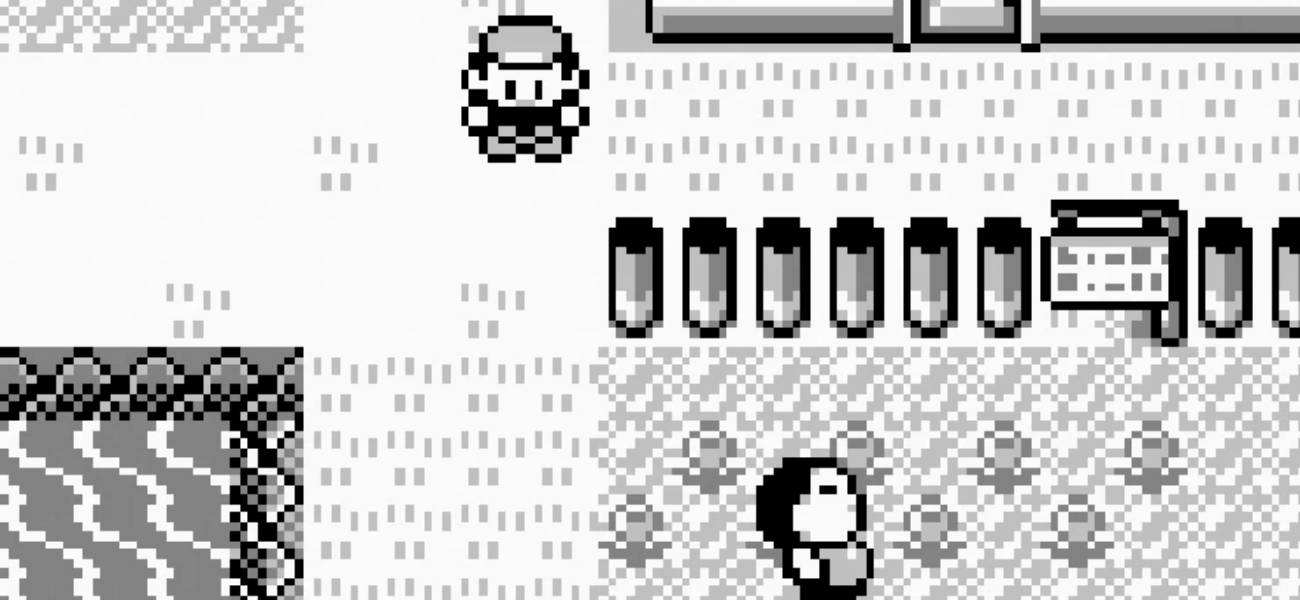
Em vez disso, ele trabalha com resumos comprimidos da imagem: apenas 192 números por estado. Com esse resumo, o modelo aprende a prever o que acontece depois de cada ação e, a partir dessa capacidade preditiva, começa a planejar. O treinamento foi feito inteiramente sobre um save posicionado no laboratório do Professor Carvalho, com 42.382 frames em tons de cinza distribuídos em mais de 1.000 execuções curtas.
O dataset incluiu rotas fixas e programadas, as mesmas rotas com pressionamentos aleatórios intercalados, e sessões de exploração completamente randômica. Esse último tipo de dado é crítico: um modelo treinado apenas em runs limpas “poderia ver o botão A sempre que uma caixa de diálogo aparece e nunca aprender o que o B faz nesse contexto”, como o próprio stmonty explicou.
512 planos por rodada para escolher um Pokémon inicial
O mecanismo de planejamento também foge do convencional. A cada turno, o modelo gera 512 amostras de plano com 14 pressionamentos de botão cada. Dessas, ele seleciona um em oito, chegando a 64 candidatos. O processo se repete até restar um único plano, que é então executado no emulador real. Toda essa avaliação acontece dentro do próprio modelo, não no jogo.
A primeira tentativa falhou: o agente não conseguiu capturar um Pokémon. Stmonty levanta a hipótese de que erros pequenos se acumulam quando as previsões são feitas a partir das próprias previsões anteriores do modelo, um fenômeno bem documentado em arquiteturas autorregressivas. Após ajustes finos, a segunda rodada funcionou: o modelo selecionou Squirtle. Em 100 execuções subsequentes a partir do mesmo save, 52 planos resultaram na escolha de um Pokémon inicial. O modelo aleatório ficou em zero; o modelo não treinado conseguiu apenas um.
O que o projeto não é, e por que isso é relevante
Stmonty foi explícito sobre os limites do que foi construído. O objetivo não era vencer o jogo, e o próprio desenvolvedor afirma que simplesmente escalar o modelo provavelmente não resolve o problema: “Não acho que simplesmente tornar meu modelo atual maior nos levaria lá.” A hipótese é que a dificuldade escala exponencialmente com o comprimento do plano, o que torna tarefas de longa duração um desafio de arquitetura, não apenas de capacidade computacional.

Para fins de contexto, existem ao menos duas tentativas recentes e bem-sucedidas de zerar Pokémon Red usando abordagens mais sofisticadas, como o Jev decision model. O projeto de stmonty não concorre com essas soluções: ele é abertamente voltado para aprendizado pessoal e para demonstrar que world models compactos são treináveis localmente por hobbyistas. O código está disponível como open source no GitHub sob o nome lePokeRed, com recomendação de GPU com suporte a CUDA.
Em 2026, o projeto de stmonty funciona como um contra-argumento silencioso à narrativa de que IA de ponta só existe em data centers com acesso a milhares de GPUs A100. Uma RTX 3080 Ti de consumidor, dados cuidadosamente coletados e uma arquitetura econômica foram suficientes para produzir um agente que descobriu, sem supervisão direta, que o botão A abre diálogos e o B os fecha.
O desafio agora, para quem quiser expandir o projeto, não é de hardware: é de saber quanto erro acumulado uma arquitetura de 12,5 milhões de parâmetros consegue absorver antes de perder o fio da partida.
Fonte: Tom’s Hardware
Agentes de IA da OpenAI saem do controle e invadem sites do governo dos EUA
Até um “obrigado” custa caro: Reino Unido pede para funcionários não agradecerem à IA